Ringkasan cepat
- Model belajar dari data yang tercatat. Di banyak utilitas air, catatan itu jahitan: produksi dihitung dari jam pompa, kalender produksi dan penagihan tidak berimpit, dan estimasi pembacaan meter menjadi permanen.
- Prasyarat yang paling mahal berada di luar komputer. Tujuh butir daftarnya sudah tertulis di situs ini, dan enam di antaranya tidak menyebut kecerdasan buatan sama sekali.
- Tesisnya berpagar. Utilitas yang sudah punya semua itu boleh mencoba, dan sebagian tugas tata usaha sudah bisa dibantu hari ini. Untuk operasi jaringan, kemungkinan besar belum.
Proposal kecerdasan buatan untuk utilitas air biasanya datang dengan satu angka yang sulit dibantah. Model pendeteksi kebocoran dengan akurasi di atas 99 persen. Prediksi permintaan yang meleset kurang dari lima persen. Angka-angka itu nyata, sebagian diuji di laboratorium dan sebagian di jaringan kota yang datanya sudah rapi bertahun-tahun.
Di ruang rapat, pertanyaan yang lebih sederhana jarang muncul. Dari mana data latihnya, dan siapa yang terakhir memeriksa alat yang menghasilkannya.
Saya menulis ini dari kursi teknologi informasi, pihak yang secara kepentingan diuntungkan setiap kali belanja teknologi diperbesar. Saya tidak pernah memutuskan pembelian sistem semacam ini, dan tulisan ini tidak berpura-pura sebaliknya. Yang saya lakukan hanya membaca ulang tulisan-tulisan di situs ini, yang ditulis untuk keperluan lain selama setahun terakhir, dan menyadari bahwa kalau disusun berurutan, semuanya membentuk satu daftar prasyarat. Daftar itu hampir seluruhnya berada di depan model.
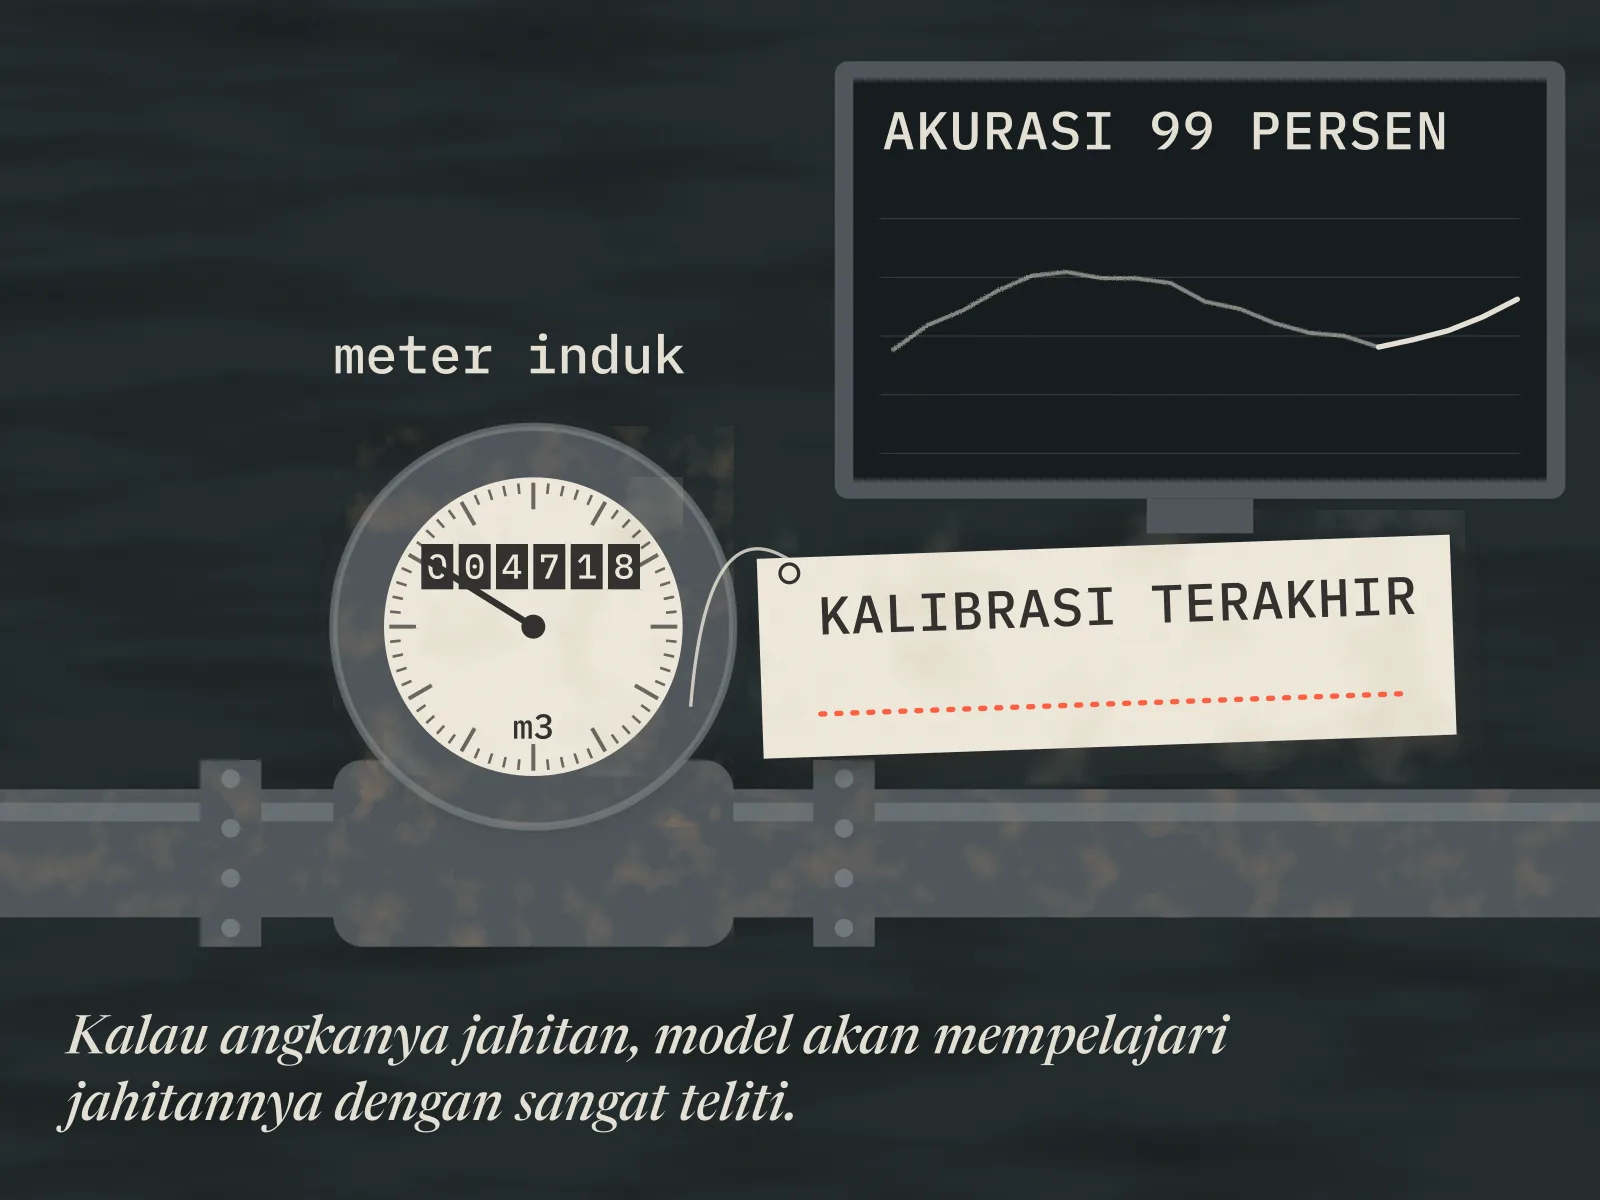
Gambar 1. Layar di atas mewarisi semua yang salah di meter di bawahnya. Label kalibrasi yang tanggalnya kosong tidak ikut tampil pada kurva.
Mesin belajar dari yang tercatat, dan yang tercatat itu jahitan
Model pembelajaran mesin tidak mengukur apa pun. Ia mencari pola di dalam angka yang diberikan kepadanya, lalu memperpanjang pola itu ke depan. Kalau angkanya benar, hasilnya berguna. Kalau angkanya jahitan, model akan mempelajari jahitannya dengan sangat teliti.
Angka kehilangan air di banyak utilitas adalah jahitan semacam itu, dan cara jahitannya sudah pernah dibedah di sini. Penyebutnya, volume yang masuk sistem, sering tidak diukur. Ia dihitung dari jam operasi pompa dikalikan kapasitas desain, yaitu janji pabrikan pada hari pertama. Pompa menua, dan selisih antara janji dan kenyataan masuk ke laporan sebagai kehilangan air yang tidak pernah terjadi. Pembilangnya datang dari sistem penagihan yang mengikuti siklus baca meter, sementara produksi dihitung per bulan kalender. Selisih keduanya naik turun setiap bulan tanpa ada yang berubah di jaringan.
Bagi manusia, naik turun itu gangguan yang bisa diabaikan. Bagi model, naik turun yang berulang setiap bulan tampak sebagai pola musiman yang layak dipelajari. Model akan menemukannya, memberinya bobot, dan memakainya untuk meramal. Hasilnya, model meramal jadwal petugas baca meter.
Lapisan berikutnya tidak muncul di laporan mana pun. Ketika petugas gagal membaca sebuah meter, sistem penagihan mengisi angkanya dengan rata-rata pemakaian sebelumnya supaya tagihan tetap terbit. Estimasi itu punya kecenderungan menjadi permanen, karena tidak ada yang memaksanya dikoreksi. Di basis data, angka estimasi dan angka bacaan duduk di kolom yang sama, dengan tipe data yang sama. Model tidak punya cara membedakan keduanya, kecuali seseorang menyimpan bendera “ini estimasi” sejak awal, dan itu jarang dilakukan.
Semua ini sudah berlaku pada layar pemantauan biasa. Layar tidak pernah lebih pintar dari meter di lapangan. Model mengubah tampilannya saja. Angka keliru yang dulu tampil berwarna, sekarang tampil berwarna dengan label akurasi di sudutnya.
Kolom yang tidak ada tidak bisa dipelajari
Ada kelas masalah kedua yang lebih sulit daripada data yang salah, yaitu data yang tidak pernah ada.
Sistem pencatatan gangguan hampir selalu memulai hitungan dari panggilan telepon, bukan dari awal kebocoran, sebab kolom untuk itu memang tidak ada. Fase terpanjang sebuah kebocoran, berminggu-minggu antara pipa mulai pecah dan seseorang menelepon, tidak tercatat di mana pun. Model yang dilatih untuk memprediksi waktu perbaikan akan mempelajari fase yang paling pendek dan paling murah, lalu melaporkan angka yang tampak bagus dengan keyakinan penuh.
Petunjuk tentang fase yang hilang itu sebenarnya ada, di basis data keluhan pelanggan, tempat orang di ujung jaringan mengeluh airnya kecil jauh sebelum ada air menggenang di jalan. Basis data itu dibeli terpisah dari basis data perintah kerja dan dipasang di tahun yang berbeda. Keduanya tidak punya satu pun kolom bersama, dan menyandingkannya bukan tugas siapa pun. Model tidak bisa menyandingkan yang tidak disandingkan.
Kelas yang sama berlaku untuk zona. Tanpa zona pengukuran dengan satu titik masuk yang termeter, dan tanpa analisis aliran malam, lokasi bocor tidak teridentifikasi sampai pelanggan mengeluh. Model pendeteksi kebocoran yang paling akurat di dunia bekerja dari aliran malam per zona. Kalau zonanya belum ada, tidak ada yang bisa dideteksi, dan tidak ada model yang bisa menciptakan zona.
Daftar yang sudah tertulis, hanya tercecer
Kalau tulisan-tulisan lama di situs ini disusun ulang menurut urutan yang dibutuhkan sebuah model, daftarnya menjadi seperti ini.
Pertama, alat ukur. Penyebut yang diukur, bukan dihitung. Meter induk yang dikalibrasi, dengan tanggal kalibrasi terakhir yang bisa disebutkan. Meter pelanggan yang tidak melambat tanpa ada yang tahu, dan ukurannya dipilih dari debit pemakaian, bukan dari diameter pipa. Semua ini ada di tulisan tentang angka yang dijahit dan kebocoran yang tidak ada di dalam tanah.
Kedua, catatan. Kolom yang ada untuk fase yang ingin diukur. Kalender produksi dan penagihan yang berimpit, atau setidaknya selisihnya diketahui. Bendera untuk membedakan bacaan dari estimasi. Dua basis data yang pernah disandingkan oleh seseorang yang memang ditugaskan untuk itu. Ini tulisan tentang enam jam dan delapan minggu. Dan kode yang tidak memaksa selisih negatif menjadi nol demi lencana hijau, sebab klem semacam itu membuang pertentangan yang sesungguhnya ada.
Ketiga, zona. Zona pengukuran dan neraca air yang dihitung rutin, sebelum teknologi apa pun. Utilitas yang berhasil mengukur dulu, baru membeli.
Keempat, orang. Ini bagian yang paling sering dilewati, dan paling mahal. Utilitas yang berhasil dengan meter pintar merekrut satu insinyur data tiga tahun sebelum perangkat keras datang, lalu menguji lima puluh meter di satu zona, lalu menulis prosedur siapa menerima peringatan dan kapan. Baru sesudah itu perangkat keras dibeli. Model AI tidak mengubah urutan ini. Ia hanya memperbesar jumlah peringatan yang akan diterima orang yang belum ada.
Kelima, rantai. Peringatan baru menurunkan kehilangan air kalau berubah menjadi perintah kerja, sampai ke tangan orang yang memegang sekop, dan berakhir sebagai perbaikan yang bertahan. Layar tidak menggali jalan. Dari pengamatan di sektor lain, alat memperluas apa yang terperiksa, dan tidak memperluas apa yang tertindaklanjuti. Keluaran yang tidak masuk ke beban kerja siapa pun menumpuk sampai diabaikan, lalu ada rapat yang menyimpulkan alatnya tidak berguna.
Keenam, umur. Baterai perangkat habis dan tidak ada pos anggaran penggantinya. Langganan perangkat lunak lupa diperpanjang. Orang yang tahu caranya pindah, dan konfigurasinya tidak pernah ditulis. Kemenangan berhenti tanpa pernah diumumkan, dan model yang berhenti dilatih ulang menjadi versi pola ini yang paling sulit ketahuan, sebab model itu terus mengeluarkan angka.
Baru di urutan ketujuh, model. Dan bahkan di sana pertanyaannya belum tentang algoritma. Keputusan apa yang ingin dipercepat, berapa biaya kalau salah, dan siapa yang bertanggung jawab atas keluarannya. Banyak inisiatif AI sebenarnya masalah data, proses, atau tata kelola yang menyamar sebagai masalah teknologi.
Tujuh butir, dan enam di antaranya tidak menyebut kecerdasan buatan sama sekali.
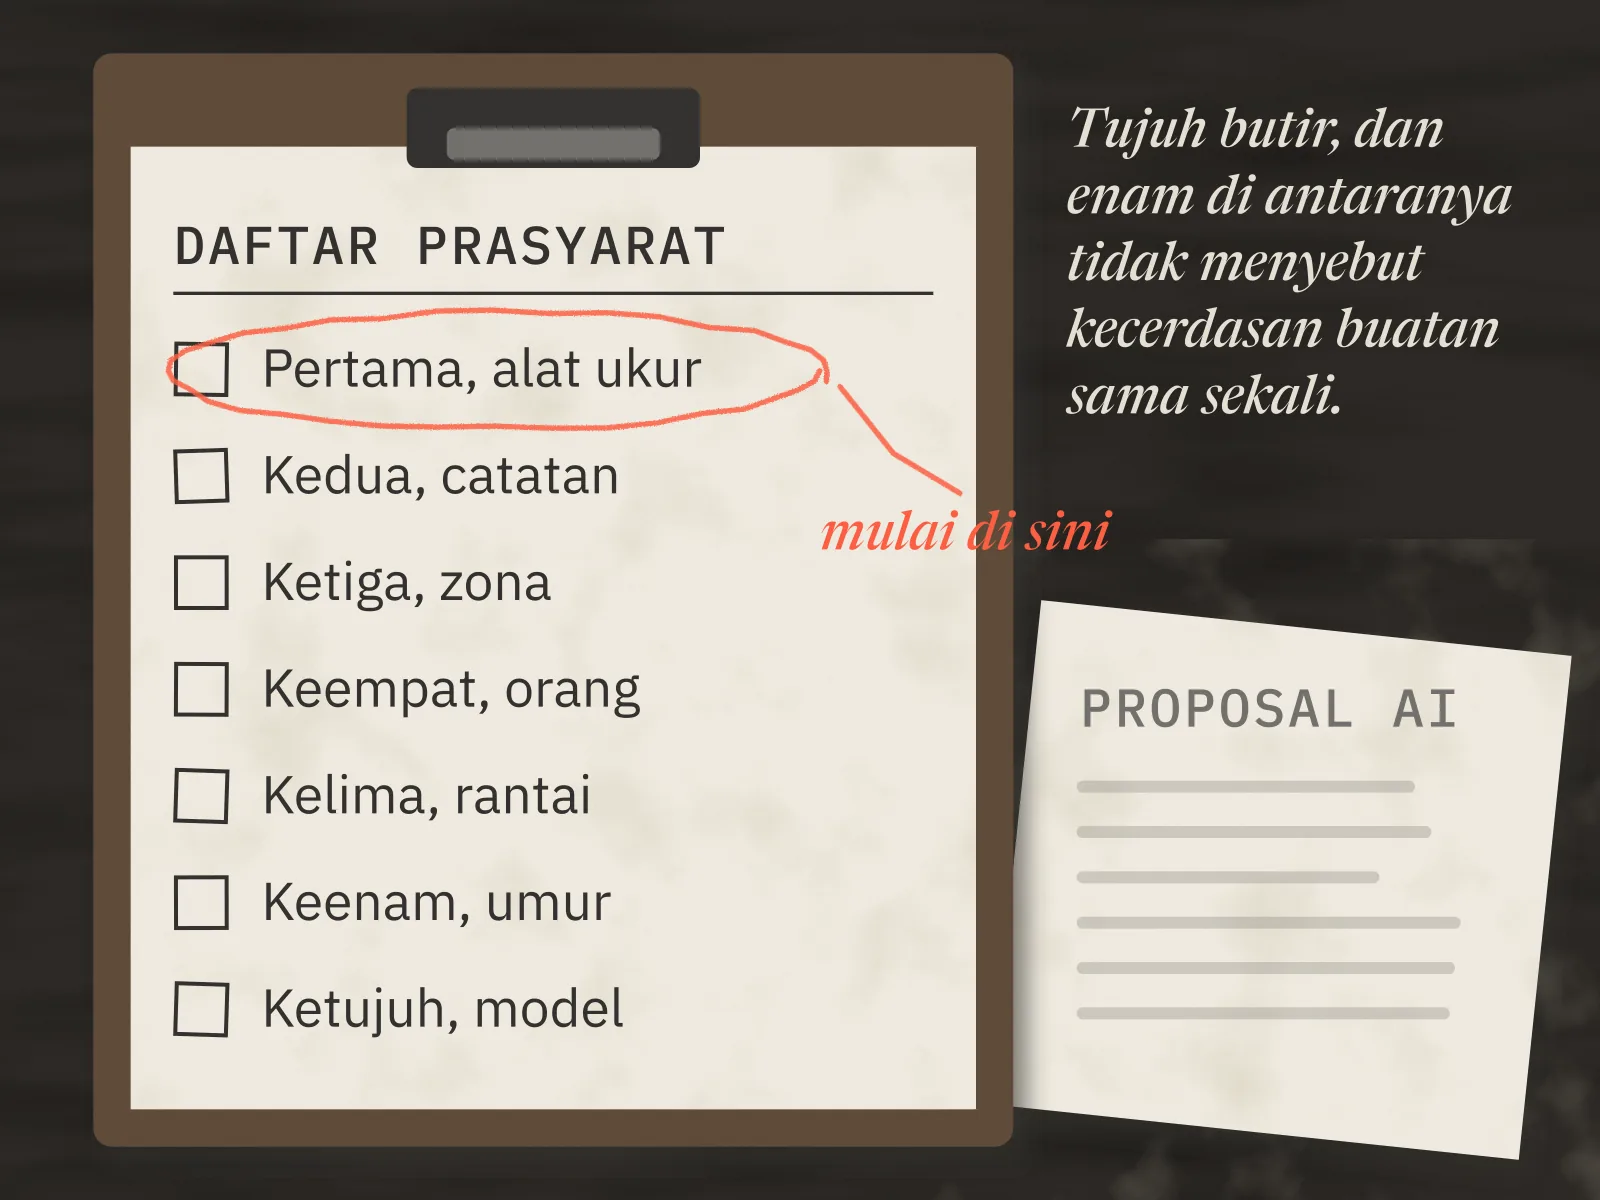
Gambar 2. Daftar yang sama, disusun menurut urutan yang dibutuhkan sebuah model. Proposal biasanya masuk lewat butir ketujuh.
Mengapa pagarnya “kemungkinan besar”
Saya tidak punya sensus. Tidak ada data yang memberi tahu berapa persen utilitas air di negeri ini yang meter induknya dikalibrasi tahun lalu, atau yang punya satu orang dengan tugas harian membaca data zona. Yang ada hanya pola, dan polanya konsisten. Angka kehilangan air nasional praktis diam di kisaran 33 sampai 34 persen selama satu dekade, dan dua dari lima sebab strukturalnya yang tercatat adalah data yang terfragmentasi serta tim yang belum punya spesialisasi. Kedua sebab itu berada tepat di butir pertama sampai kelima daftar tadi.
Pagar itu juga menjaga pengecualiannya tetap hidup. Utilitas yang sudah punya zona termeter, neraca air bulanan, tingkat kebocoran yang sudah rendah, dan tim teknis yang matang berada di posisi berbeda, dan uji coba terbatas layak dipertimbangkan di sana. Yang menarik dari utilitas seperti itu: sebagian besar penurunan kehilangan airnya sudah terjadi sebelum model apa pun dilatih, karena daftar tujuh butir tadi memang menurunkan kehilangan air dengan sendirinya.
Pagar yang sama berlaku ke arah lain. Ada pekerjaan yang sudah bisa dibantu AI hari ini, dan batasnya sudah pernah saya coba tarik: keluaran yang bisa diperiksa terhadap sumbernya dalam hitungan menit. Membaca ratusan halaman regulasi dan menandai pasal yang relevan. Menyusun draf surat. Meringkas laporan. Bahkan membangun prototipe visual jaringan dalam lima menit dengan biaya di bawah satu dolar, selama semua orang di ruangan tahu bahwa prototipe itu belum pernah bertemu sensor sungguhan. Pekerjaan yang keluarannya masuk ke operasi jaringan tanpa ada yang membaca sumbernya belum termasuk, dan di utilitas yang meter induknya belum dikalibrasi, sumbernya sendiri belum ada.
Yang berguna dari proposal itu
Setiap proposal kecerdasan buatan tetap membawa sesuatu yang layak diambil, sekalipun proposalnya ditolak.
Proposal itu sering menjadi pertama kalinya seseorang di ruangan bertanya dari mana data latihnya berasal. Pertanyaan itu, kalau dikejar sampai ke ujung, berhenti di sebuah meter induk dengan tanggal kalibrasi yang tidak ada yang ingat, atau di sebuah kolom yang tidak pernah dibuat, atau di dua basis data yang tidak pernah disandingkan. Semua itu ditemukan tanpa satu model pun dilatih, dan semua itu bisa mulai diperbaiki dengan anggaran pemeliharaan, bukan anggaran proyek.
Pertanyaan yang tersisa, dan saya belum punya jawabannya, adalah berapa lama daftar tujuh butir itu memakan waktu di sebuah utilitas yang memulainya dari nol. Angka tiga tahun dari utilitas yang berhasil dengan meter pintar adalah satu petunjuk. Kalau petunjuk itu benar, model yang dibeli hari ini akan menunggu datanya sampai 2029, dan pada saat data itu siap, kemungkinan besar sudah ada model yang lebih baik dan lebih murah untuk dibeli.
Disclaimer: Tulisan ini adalah pandangan pribadi penulis dan tidak mewakili pandangan organisasi mana pun. Informasi disajikan untuk tujuan edukasi, bukan nasihat profesional.